Java und Datenbanken: JDBC, JPA und Hibernate richtig einordnen
JDBC ermöglicht direkten, kontrollierten SQL-Zugriff. Jakarta Persistence bildet Entitäten auf relationale Tabellen ab. Dieser Überblick zeigt, welche Rolle JPA, Hibernate, Treiber, Verbindungen und Transaktionen tatsächlich spielen.
Das Wichtigste vorab
Kurzfassung: ca. 1 Minute · vollständiger Artikel: ca. 13 Minuten
- JDBC ist die standardisierte Java-API für direkten Datenbankzugriff. SQL, Parameter, Ergebnismengen und Transaktionen bleiben sichtbar.
- JPA ist die geläufige ältere Bezeichnung; der heutige Standard heißt Jakarta Persistence. Es handelt sich um eine Spezifikation, nicht um ein fertiges Framework.
- Hibernate oder EclipseLink können Jakarta Persistence umsetzen. Der Provider erzeugt SQL, verwaltet Entitäten und synchronisiert Änderungen mit der Datenbank.
PreparedStatement, gebundene Parameter und try-with-resources gehören zu robustem JDBC-Code.DataSourceist für Anwendungen meist die bessere Quelle für Verbindungen als überall direkt eingesetzterDriverManager.- Die Entscheidung lautet selten „JDBC oder JPA für immer“: Viele Anwendungen nutzen Persistence für das Domänenmodell und gezieltes SQL für besondere Abfragen.
Sobald eine Java-Anwendung Daten dauerhaft speichern soll, begegnen dir Begriffe wie JDBC, JPA, Hibernate, EntityManager und Datenbanktreiber. Sie bezeichnen jedoch nicht dasselbe. Wer ihre Aufgaben sauber trennt, kann bewusster entscheiden, welche Ebene für eine Abfrage, einen Geschäftsfall oder ein ganzes Projekt sinnvoll ist.
Vier Bausteine statt eines Entweder-oder
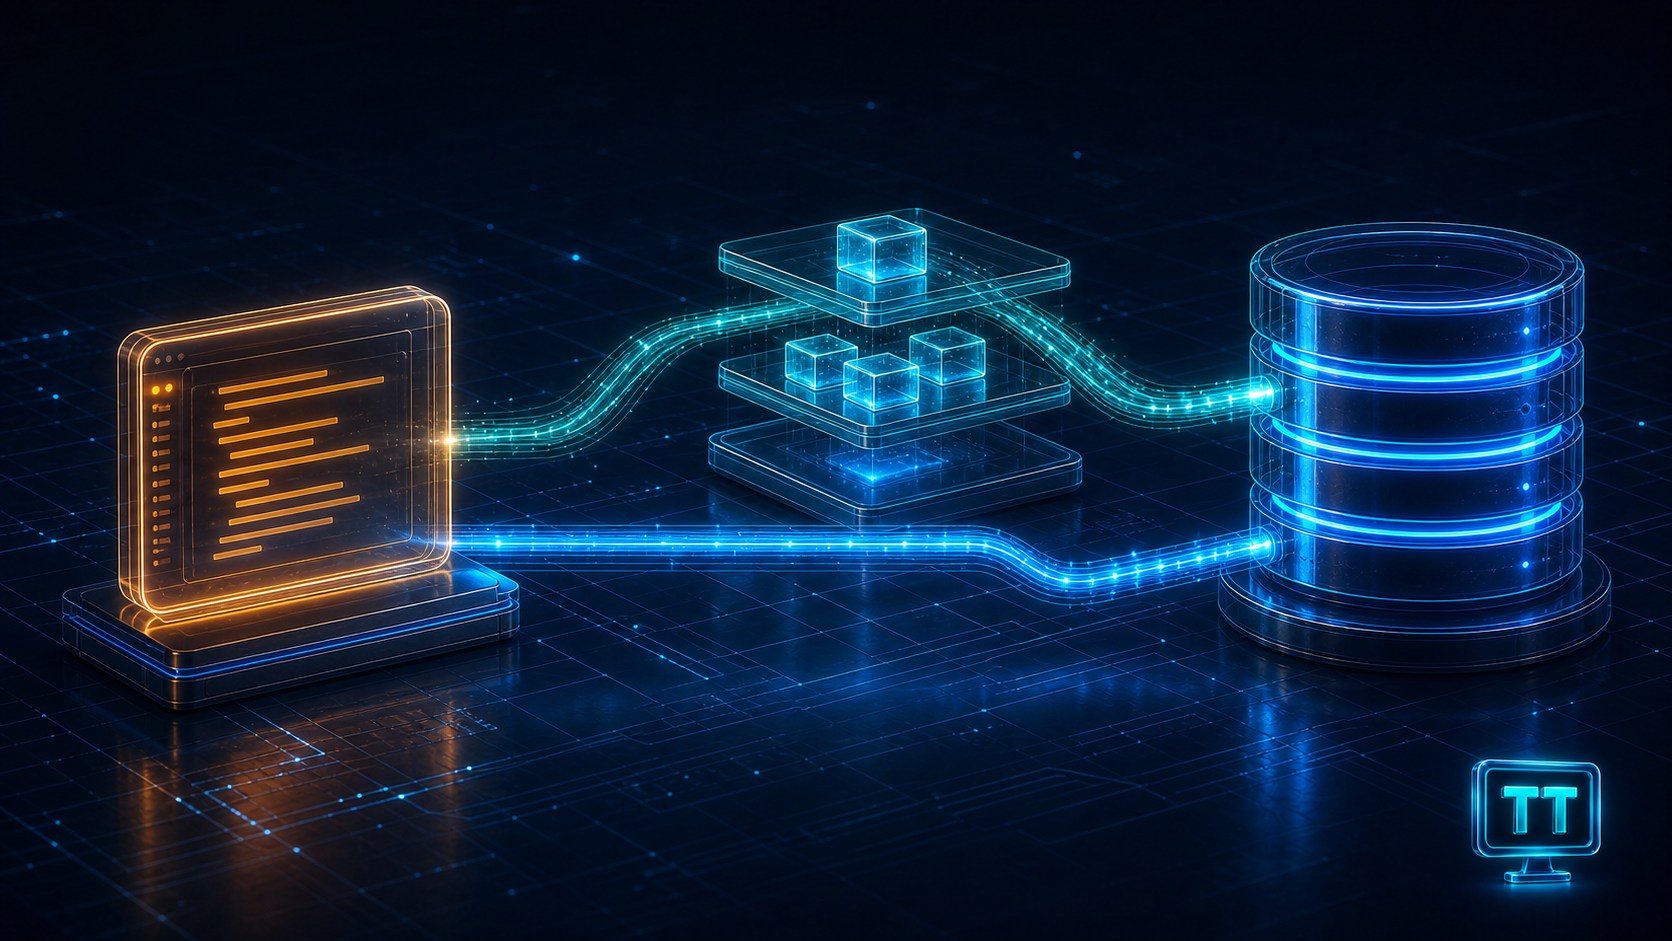
JDBC und Jakarta Persistence konkurrieren nicht auf derselben Ebene. Persistence baut für relationale Datenbanken normalerweise auf JDBC auf. Dazwischen sitzt eine Implementierung wie Hibernate, darunter der zum Datenbanksystem passende JDBC-Treiber.
| Baustein | Aufgabe | Was du im Code siehst |
|---|---|---|
| JDBC | Standard-API für Verbindungen, SQL-Anweisungen, Ergebnisse und Transaktionen | Connection, PreparedStatement, ResultSet |
| Jakarta Persistence | Spezifikation für objektrelationale Abbildung und das Verwalten von Entitäten | @Entity, EntityManager, JPQL |
| Persistence-Provider | Konkrete Umsetzung der Spezifikation | Zum Beispiel Hibernate ORM oder EclipseLink |
| JDBC-Treiber | Übersetzt JDBC-Aufrufe in das Protokoll des Datenbanksystems | Abhängigkeit für PostgreSQL, MariaDB, H2 und andere Datenbanken |
JDBC: SQL bewusst kontrollieren
JDBC gehört zur Java-Plattform. Die Pakete java.sql und javax.sql definieren, wie Java-Code Verbindungen öffnet, SQL ausführt und tabellarische Ergebnisse liest. Das Datenmodell bleibt dabei relational: Tabellen, Spalten, Joins und Transaktionen sind im Anwendungscode ausdrücklich erkennbar.
Diese Nähe zur Datenbank ist besonders nützlich, wenn eine Abfrage genau abgestimmt werden soll, große Datenmengen verarbeitet werden oder vorhandenes SQL übernommen werden muss. Der Preis dafür ist mehr Infrastrukturcode: Parameter müssen gebunden, Ergebnisse in Java-Objekte übertragen und Ressourcen zuverlässig geschlossen werden.
Typische Stärken
- SQL und ausgeführte Spalten sind unmittelbar sichtbar.
- Datenbankspezifische Funktionen lassen sich gezielt nutzen.
- Speicherbedarf und Verarbeitung großer Ergebnismengen können fein gesteuert werden.
- Für kleine, klar umrissene Datenzugriffe bleibt die Abstraktion schlank.
Typische Kosten
- Zeilen müssen manuell in Objekte übersetzt werden.
- Änderungen am Schema wirken sich direkt auf SQL und Mapping-Code aus.
- Beziehungen und Objektzustände verwaltet die Anwendung selbst.
- Fehler beim Ressourcen- oder Transaktionsmanagement sind leicht möglich.
Ein robustes JDBC-Beispiel
Im folgenden Beispiel liefert die Laufzeitumgebung oder Bibliothek ein DataSource-Objekt. Die SQL-Anweisung enthält einen Platzhalter, der Wert wird getrennt gebunden. Alle schließbaren JDBC-Ressourcen liegen in try-with-resources-Blöcken.
import javax.sql.DataSource;
import java.sql.Connection;
import java.sql.PreparedStatement;
import java.sql.ResultSet;
import java.sql.SQLException;
import java.util.Optional;

record Book(long id, String title) {}

static Optional findBook(DataSource dataSource, long id)
        throws SQLException {

    String sql = """
            SELECT id, title
            FROM book
            WHERE id = ?
            """;

    try (Connection connection = dataSource.getConnection();
         PreparedStatement statement = connection.prepareStatement(sql)) {

        statement.setLong(1, id);

        try (ResultSet result = statement.executeQuery()) {
            if (!result.next()) {
                return Optional.empty();
            }

            return Optional.of(new Book(
                    result.getLong("id"),
                    result.getString("title")
            ));
        }
    }
}
Was daran wichtig ist
DataSourcetrennt den Anwendungscode von den Details der Verbindungserzeugung und kann mit einem Connection-Pool zusammenarbeiten.PreparedStatementbindet den Wert alslong. Benutzereingaben werden nicht durch Zeichenkettenverkettung in SQL eingebaut.- try-with-resources schließt
ResultSet,PreparedStatementundConnectionauch bei einer Ausnahme. - Das kleine
record Bookist hier das Ziel des manuellen Mappings.
Transaktionen und Verbindungen gehören zum Entwurf
Zwei SQL-Anweisungen können fachlich eine Einheit bilden. Dann dürfen nicht versehentlich nur einzelne Änderungen gespeichert werden. Eine JDBC-Transaktion setzt deshalb Auto-Commit vorübergehend aus, bestätigt den gesamten Vorgang mit commit() oder nimmt ihn mit rollback() zurück.
static void transfer(DataSource dataSource,
                     long sourceId,
                     long targetId,
                     BigDecimal amount) throws SQLException {

    try (Connection connection = dataSource.getConnection()) {
        boolean previousAutoCommit = connection.getAutoCommit();
        connection.setAutoCommit(false);

        try {
            debit(connection, sourceId, amount);
            credit(connection, targetId, amount);
            connection.commit();
        } catch (SQLException exception) {
            try {
                connection.rollback();
            } catch (SQLException rollbackException) {
                exception.addSuppressed(rollbackException);
            }
            throw exception;
        } finally {
            connection.setAutoCommit(previousAutoCommit);
        }
    }
}
Die Hilfsmethoden debit und credit stehen hier stellvertretend für zwei vorbereitete Update-Anweisungen. In einer echten Überweisung müssen zusätzlich Fachregeln, Parallelzugriffe und geeignete Isolations- beziehungsweise Sperrstrategien berücksichtigt werden.
JPA heißt heute Jakarta Persistence
Jakarta Persistence beschreibt, wie Java-Objekte als Entitäten verwaltet und auf relationale Tabellen abgebildet werden. Die Spezifikation legt APIs und Verhalten fest; ein Provider wie Hibernate ORM oder EclipseLink übernimmt die konkrete Arbeit. Deshalb ist die Aussage „JPA ist ein Framework“ ungenau.
Die Abstraktion verbirgt SQL nicht vollständig. Der Provider erzeugt es aus Metadaten, Objektänderungen und Abfragen. Wer Persistence verwendet, muss deshalb weiterhin relationale Datenmodelle, Indizes, Transaktionen und das resultierende SQL verstehen.
| Älter oder umgangssprachlich | Aktuelle Einordnung |
|---|---|
| JPA | Geläufiger Name für die heutige Spezifikation Jakarta Persistence |
javax.persistence.* |
In aktuellen Jakarta-Versionen: jakarta.persistence.* |
| „Hibernate = JPA“ | Hibernate ist ein Provider und bietet zusätzlich eigene Funktionen. |
| „Kein SQL mehr“ | SQL wird häufig erzeugt, muss aber weiterhin beobachtet und optimiert werden. |
Entitäten und der Persistence Context
Eine Entitätsklasse repräsentiert dauerhaft gespeicherte Identität. Annotationen beschreiben das Mapping. Der geschützte parameterlose Konstruktor wird vom Provider benötigt; der öffentliche Konstruktor sorgt in diesem Beispiel dafür, dass ein Buch nicht ohne Titel entsteht.
import jakarta.persistence.Column;
import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;
import jakarta.persistence.Table;
import java.util.Objects;

@Entity
@Table(name = "book")
public class BookEntity {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(nullable = false, length = 200)
    private String title;

    protected BookEntity() {
        // Für den Persistence-Provider
    }

    public BookEntity(String title) {
        this.title = Objects.requireNonNull(title);
    }

    public Long getId() {
        return id;
    }

    public String getTitle() {
        return title;
    }
}
Der EntityManager arbeitet mit einem Persistence Context. Darin verwaltete Entitäten besitzen eine Identität; Änderungen können innerhalb einer Transaktion erkannt und später mit der Datenbank synchronisiert werden. Dieses sogenannte Dirty Checking spart Update-Code, macht den Zeitpunkt des tatsächlichen SQL-Aufrufs aber weniger offensichtlich als bei JDBC.
List books = entityManager.createQuery(
        """
        select b
        from BookEntity b
        where lower(b.title) like lower(:pattern)
        order by b.title
        """,
        BookEntity.class
    )
    .setParameter("pattern", prefix + "%")
    .setMaxResults(25)
    .getResultList();
JPQL adressiert Entitäten und deren Attribute, nicht direkt Tabellen und Spalten. Auch hier wird der Wert über einen Parameter übergeben. Der Provider übersetzt die Abfrage anschließend in SQL für das verwendete Datenbanksystem.
JDBC oder Jakarta Persistence?
Die passende Wahl hängt nicht von einer pauschalen Rangliste ab, sondern vom Datenzugriff. Ein klarer SQL-Bericht stellt andere Anforderungen als ein Domänenmodell mit vielen Beziehungen und Zustandsänderungen.
| Anforderung | Häufig passender Ansatz | Warum |
|---|---|---|
| Wenige, gezielte SQL-Abfragen | JDBC | Geringe Abstraktion und vollständige Kontrolle |
| Komplexe Reports und Aggregationen | JDBC oder native Abfrage | SQL bildet Joins und Aggregationen unmittelbar ab. |
| Domänenmodell mit Lebenszyklus und Beziehungen | Jakarta Persistence | Identität, Mapping und Zustandsverwaltung sind standardisiert. |
| Viele gleichartige CRUD-Vorgänge | Jakarta Persistence | Weniger wiederholter Mapping- und Update-Code |
| Bulk-Import oder massenhafte Updates | JDBC oder Bulk-Mechanismen | Objekte einzeln zu verwalten wäre oft unnötig teuer. |
| Gemischte Unternehmensanwendung | Kombination | Persistence für das Modell, gezieltes SQL für Sonderfälle |
Performance ohne Mythen
JDBC ist nicht automatisch schnell und Persistence nicht automatisch langsam. Entscheidend sind die ausgeführten Abfragen, übertragene Datenmenge, Indizes, Roundtrips, Transaktionsdauer und das Zugriffsmuster. Eine schlechte SQL-Anweisung bleibt auch dann schlecht, wenn sie sorgfältig in Java eingebettet wurde.
Bei JDBC beobachten
- Nur benötigte Spalten auswählen
- Parameter statt zusammengesetzter SQL-Texte verwenden
- Batch-Verarbeitung für viele gleichartige Änderungen prüfen
- Ergebnismengen nicht unnötig vollständig in den Speicher laden
- Verbindungen und Transaktionen kurz halten
Bei Persistence beobachten
- N+1-Abfragen und unbemerkte Nachladevorgänge erkennen
- Fetch-Strategien am konkreten Anwendungsfall ausrichten
- Für Listen DTO-Projektionen und Begrenzungen erwägen
- Große Schreibvorgänge nicht blind über Einzelentitäten abwickeln
- Erzeugtes SQL und Ausführungspläne tatsächlich ansehen
Java und Kotlin: dieselben Datenbankgrundlagen
Kotlin auf der JVM verwendet dieselben JDBC-Schnittstellen und Persistence-Provider. Die Standardfunktion use übernimmt bei JDBC eine ähnliche Rolle wie try-with-resources in Java und schließt Ressourcen nach dem Block.
fun findBook(dataSource: DataSource, id: Long): Book? =
    dataSource.connection.use { connection ->
        connection.prepareStatement(
            "SELECT id, title FROM book WHERE id = ?"
        ).use { statement ->
            statement.setLong(1, id)

            statement.executeQuery().use { result ->
                if (result.next()) {
                    Book(result.getLong("id"), result.getString("title"))
                } else {
                    null
                }
            }
        }
    }
Bei Persistence-Entitäten verdienen Kotlin-Besonderheiten wie standardmäßig finale Klassen, Null-Sicherheit und vom Provider erwartete Konstruktoren zusätzliche Aufmerksamkeit. Die grundlegende Architekturentscheidung zwischen direktem SQL und einem Persistence Context bleibt jedoch dieselbe.
So geht die Datenbank-Reihe weiter
Dieser Artikel liefert das gemeinsame Begriffs- und Entscheidungsmodell. Die nächsten beiden Teile setzen die Ebenen getrennt in kleinen H2-Beispielen um. Dadurch kannst du erst JDBC nachvollziehen und anschließend sehen, welche Aufgaben Jakarta Persistence übernimmt.
JDBC-Verbindung mit einer H2-In-Memory-Datenbank
Verbindung öffnen, SQL ausführen und Ergebnisse mit den JDBC-Bausteinen verarbeiten.
Jakarta Persistence mit H2 praktisch anwenden
Eine Entität abbilden und über einen Persistence-Provider dauerhaft speichern.
Best Practices für beide Ansätze
Gute Gewohnheiten
- SQL-Parameter konsequent binden
- Zugangsdaten außerhalb des Quellcodes konfigurieren
- Transaktionsgrenzen an fachlichen Vorgängen ausrichten
- Datenbankschema mit versionierten Migrationen pflegen
- Integrationstests gegen eine realistische Datenbank ergänzen
- Abfragen, Laufzeiten und erzeugtes SQL beobachten
Häufige Fehlentscheidungen
- SQL aus ungeprüften Zeichenketten zusammensetzen
- Connections als globale, langlebige Objekte halten
- JPA mit Hibernate gleichsetzen
- Lazy Loading außerhalb klarer Transaktionsgrenzen auslösen
- Das Produktionsschema automatisch aus Entitäten überschreiben lassen
- Performance nur anhand der gewählten Bibliothek beurteilen
Glossar
- Connection
- Eine JDBC-Sitzung mit einer Datenbank. Sie bildet zugleich die Grenze für lokale JDBC-Transaktionen.
- DataSource
- Abstraktion zur Beschaffung von Datenbankverbindungen; sie kann mit Pooling und verwalteten Transaktionen zusammenspielen.
- Entity
- Ein Objekt mit dauerhafter Identität, dessen Zustand über Jakarta Persistence gespeichert werden kann.
- EntityManager
- Zentrale Jakarta-Persistence-Schnittstelle zum Finden, Speichern, Entfernen und Abfragen von Entitäten.
- JDBC
- Standardisierte Java-API für den Zugriff auf relationale und tabellarische Datenquellen.
- JPA
- Weiterhin gebräuchliche Kurzbezeichnung für die Spezifikation, die heute Jakarta Persistence heißt.
- Persistence Context
- Kontext, in dem ein Provider Identität und Zustand verwalteter Entitäten verfolgt.
- PreparedStatement
- Vorbereitete JDBC-Anweisung mit Platzhaltern und typgebundener Parameterübergabe.
- Provider
- Konkrete Implementierung der Persistence-Spezifikation, etwa Hibernate ORM oder EclipseLink.
Fazit
JDBC gibt dir direkten Zugriff auf SQL, Ergebnisse und Transaktionen. Jakarta Persistence ergänzt eine standardisierte Abbildung zwischen Java-Objekten und relationalen Tabellen; ein Provider wie Hibernate setzt diese Regeln um. Keine Ebene ersetzt solides Datenbankwissen.
Für den Einstieg lohnt sich deshalb die Reihenfolge dieser Serie: zuerst das Schichtenmodell verstehen, danach eine überschaubare JDBC-Verbindung selbst aufbauen und anschließend dieselbe Datenbank aus Sicht von Persistence betrachten. So bleibt sichtbar, welche Arbeit die jeweilige Abstraktion übernimmt.


 tiny-tool.de
 tiny-tool.de