Ein Vertrag für Trennzeichen, Positionen und echte Dateifehler
CSV und Legacy-Dateien automatisch validieren: Profile für Schnittstellen
Eine Datei kann lesbar sein und trotzdem den vereinbarten Vertrag verletzen: eine fehlende Pflichtspalte, eine Zahl als Text oder ein Datensatz mit verschobenen Positionen. Gerade bei Datei-Schnittstellen ist deshalb wichtig, den Inhalt nicht nur zu öffnen, sondern systematisch zu prüfen.
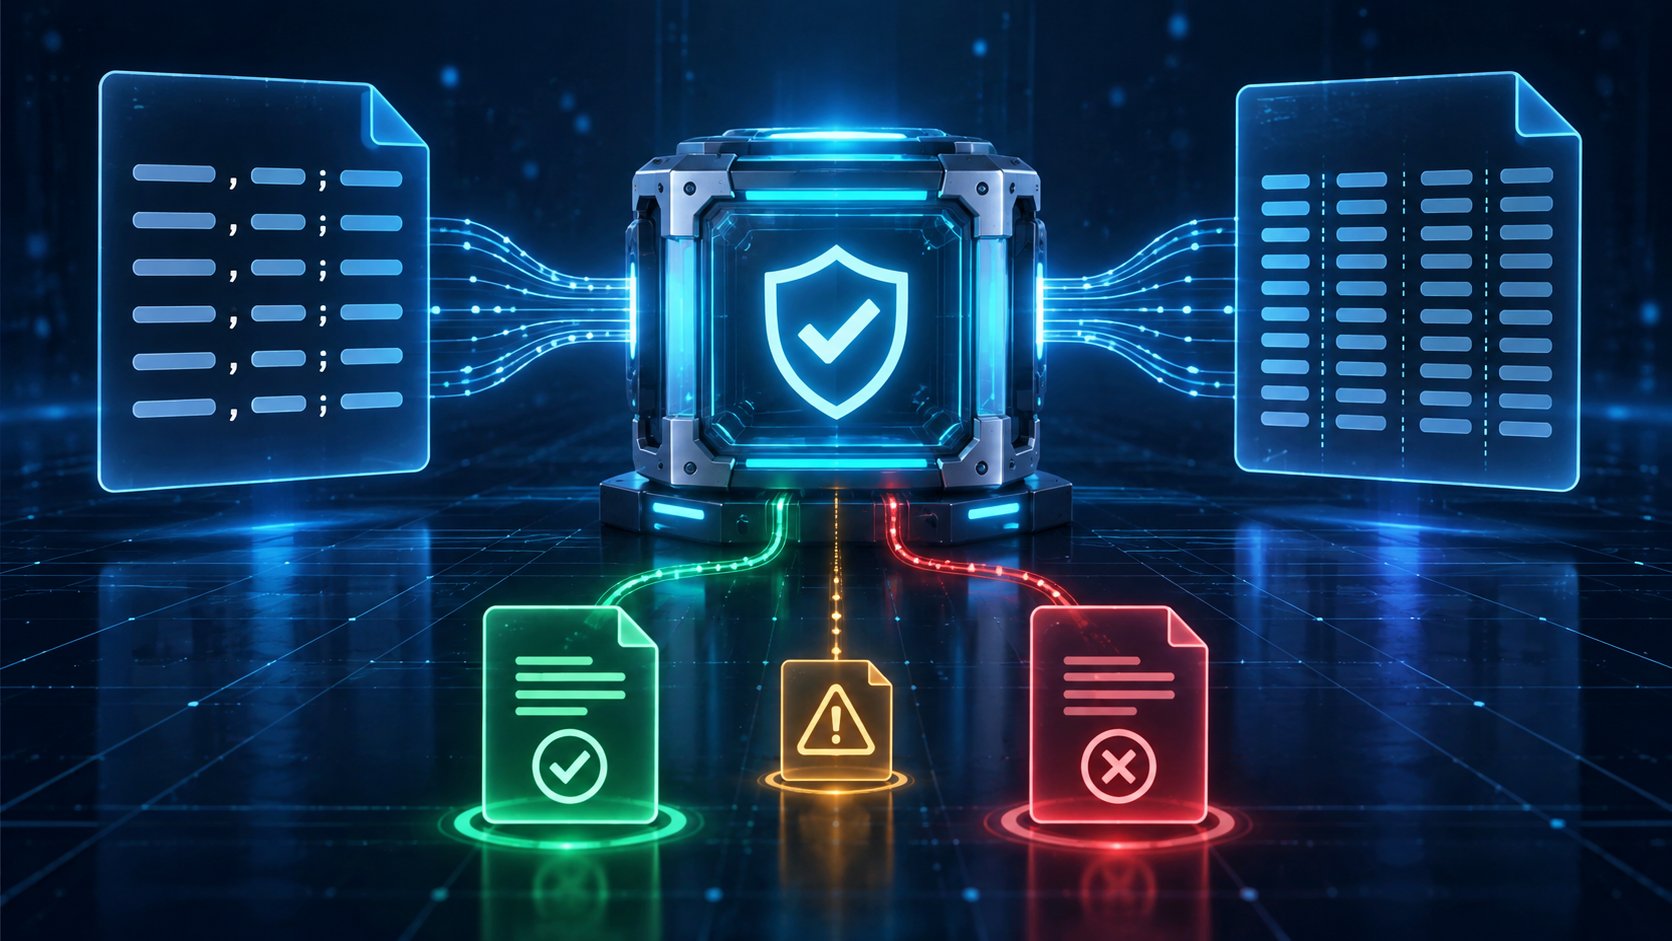
In Iteration 2 ergänzt ZEUS Interface Quality zwei konkrete lokale Prüfpfade: CSV-Dateien und Fixed-Width-Dateien. Beide liefern denselben Bericht und dieselben Exit-Codes wie die JSON-Prüfung. Ihre Regeln bleiben jedoch in eigenen Profilen, weil CSV und Legacy-Layouts unterschiedliche Annahmen mitbringen.
Die übergeordnete Frage – wie sich Schnittstellen automatisch testen lassen – steht im Hauptartikel zur automatischen Schnittstellenqualität. Die abgeschlossene erste Ausbaustufe mit JSON Schema erklärt der Praxisartikel zu Iteration 1. Dieser Artikel zeigt den nächsten vertikalen Strang: vom Datei-Profil bis zum reproduzierbaren Ergebnis.
Was Iteration 2 liefert
Die zweite Ausbaustufe bleibt bewusst lokal und überschaubar. Sie ergänzt nicht sofort FTP, SFTP oder einen kompletten Legacy-Compiler, sondern prüft zuerst die Dateien, sobald sie vorliegen.
- CSV: Trennzeichen, Zeichencodierung, exakte Kopfzeile, Spaltenanzahl und Spaltenregeln.
- Fixed-Width: Zeichencodierung, Datensatzlänge, 1-basierte Positionen und Feldlängen.
- Gemeinsam: Pflichtwerte, Typen, Mindest- und Höchstwerte, Mindest- und Maximallängen, Muster, stabile Findings und Exit-Codes.
- CLI: Das Profil kann mit
--input-format AUTOautomatisch als CSV oder Fixed-Width erkannt werden; die ausdrückliche Auswahl bleibt möglich. - Nicht enthalten: Transport, fachliche Regeln über mehrere Datensätze und automatische Ableitung aus Quelltext.
Ein Ergebnisvertrag für mehrere Dateiformate
Der Validator erhält je nach Eingabeformat einen anderen Adapter. Das Ergebnis bleibt aber ein Projektobjekt mit Status und Findings. So muss ein CI-Skript nicht wissen, ob ein Fehler aus JSON, CSV oder einer Fixed-Width-Datei stammt.
| Fall | Bedeutung | Exit-Code |
|---|---|---|
| VALID | Die Datei entspricht dem ausgewählten Profil. | 0 |
| INVALID | Die Datei ist lesbar, verletzt aber mindestens eine Regel. | 1 |
| Prüfung nicht möglich | Datei oder Profil ist nicht lesbar beziehungsweise syntaktisch unbrauchbar. | 2 |
Die Unterscheidung ist praktisch: Eine fehlende CSV-Pflichtangabe ist ein Fehler der gelieferten Daten. Ein kaputtes Profil oder eine nicht decodierbare Eingabe verhindert dagegen die Prüfung selbst. Beides muss im Betrieb unterschiedlich behandelt werden.
CSV mit einem kleinen Profil beschreiben
CSV klingt einfach, ist aber kein vollständiger Vertrag. Erst das Trennzeichen, die Codierung, die Kopfzeile und die Spaltenregeln machen aus einer Folge von Feldern eine prüfbare Lieferung. Für Iteration 2 verwenden wir dafür ein bewusst kleines JSON-Profil.
{
  "format": "csv",
  "version": 1,
  "delimiter": ";",
  "encoding": "UTF-8",
  "header": ["deliveryId", "quantity", "email"],
  "columns": [
    {
      "name": "deliveryId",
      "type": "string",
      "required": true,
      "minLength": 1
    },
    {
      "name": "quantity",
      "type": "integer",
      "required": true,
      "minimum": 1
    },
    {
      "name": "email",
      "type": "email",
      "required": true
    }
  ]
}
Das Profil schreibt die Kopfzeile ausdrücklich in der erwarteten Reihenfolge fest. Eine Datei mit vertauschten Spalten ist nicht „fast richtig“: Wenn der Vertrag positionsbezogen ist, muss die Abweichung sichtbar werden. Die Regeln für einen Wert liegen an der Spalte; dadurch kann das Finding später seinen Daten- und Profilpfad angeben.
Das ist kein Versuch, JSON Schema als Universalformat zu verkaufen. CSV benötigt Regeln für das Einlesen, die JSON Schema nicht kennt. Der Adaptervertrag darf deshalb klein und formatbezogen sein, während das Resultat formatunabhängig bleibt.
CSV-Dateien automatisch validieren
Die gültige Fixture enthält dieselbe kleine Lieferidee wie der JSON-Test, diesmal als Datei mit Semikolon-Trennzeichen. Quotierte Felder werden vom CSV-Parser berücksichtigt; die Profilprüfung beginnt erst, wenn die Datensätze gelesen werden können.
deliveryId;quantity;email
DEL-1001;3;ops@example.org
DEL-1002;12;"warehouse@example.org"
Der Aufruf kann den Adapter ausdrücklich über --input-format csv wählen. Ohne diese Option ist AUTO aktiv: Die CLI liest das Feld format aus dem Profil und wählt CSV oder Fixed-Width. JSON Schema bleibt der Fallback. Explizite Formate sind weiterhin nützlich, wenn ein Skript den erwarteten Adapter sichtbar festlegen soll.
$jar = "target/zeus-interface-quality-0.1.0-SNAPSHOT.jar"
$profile = "src/test/resources/fixtures/csv/delivery.csv-profile.json"
$input = "src/test/resources/fixtures/csv/valid-delivery.csv"

java -jar $jar validate --input-format csv --schema $profile --input $input --report json
$LASTEXITCODE
Die ungültige Variante enthält three statt einer ganzen Zahl. Der Parser kann die Zeile lesen, aber das Profil weist sie zurück:
{
  "status" : "INVALID",
  "valid" : false,
  "findings" : [ {
    "instancePath" : "/rows/0/quantity",
    "schemaPath" : "/columns/quantity/type",
    "keyword" : "type",
    "message" : "Zeile 2, Spalte quantity: 'three' ist keine ganze Zahl"
  } ]
}
/rows/0/quantity meint den ersten Daten-Datensatz und seine Spalte. Die sichtbare Zeilennummer in der Meldung berücksichtigt die Kopfzeile. So lässt sich die Abweichung in einer gelieferten Datei schnell lokalisieren.
Fixed-Width und Legacy-Dateien prüfen
Bei einer Fixed-Width-Datei gibt es kein Trennzeichen und häufig auch keine Kopfzeile. Die Bedeutung einer Stelle ergibt sich aus ihrer Position. Ein einziges zusätzliches Zeichen kann alle folgenden Felder verschieben. Das Profil muss daher die Datensatzlänge und die Feldgrenzen festlegen.
{
  "format": "fixed-width",
  "version": 1,
  "encoding": "UTF-8",
  "recordLength": 31,
  "sourceLanguage": "COBOL",
  "columns": [
    {
      "name": "recordType",
      "start": 1,
      "length": 1,
      "type": "string",
      "required": true,
      "pattern": "^D$"
    },
    {
      "name": "deliveryId",
      "start": 2,
      "length": 10,
      "type": "string",
      "required": true,
      "minLength": 1
    },
    {
      "name": "quantity",
      "start": 12,
      "length": 5,
      "type": "integer",
      "required": true,
      "minimum": 1
    },
    {
      "name": "email",
      "start": 17,
      "length": 15,
      "type": "email",
      "required": true
    }
  ]
}
Die Positionen beginnen bei eins und werden nach der Zeichendecodierung gemessen. Standardmäßig werden Feldränder entfernt, damit links- oder rechtsbündig aufgefüllte Werte geprüft werden können. Eine falsche Datensatzlänge ist ein eigener Befund; die Zeile wird dann nicht mit verschobenen Feldern weiterinterpretiert.
DDEL-1001 3ops@example.orgDer Aufruf unterscheidet sich nur beim Adapter und beim Profil. Alternativ kann --input-format fixed-width entfallen, weil das Profil format: fixed-width enthält.
$jar = "target/zeus-interface-quality-0.1.0-SNAPSHOT.jar"
$profile = "src/test/resources/fixtures/fixedwidth/delivery.cobol-profile.json"
$input = "src/test/resources/fixtures/fixedwidth/valid-delivery.dat"

java -jar $jar validate --input-format fixed-width --schema $profile --input $input --report json
$LASTEXITCODE
COBOL und RPG als Herkunft, nicht als Kopplung
Legacy-Definitionen können aus einem COBOL-Copybook, aus RPG beziehungsweise RPGLE, aus DDS oder aus einer Datenbankbeschreibung stammen. Für die erste Prüfung müssen wir nicht sofort die jeweilige Programmiersprache parsen. Entscheidend ist zunächst die daraus freigegebene Layoutbeschreibung.
Darum darf ein Fixed-Width-Profil sourceLanguage: COBOL oder sourceLanguage: RPG enthalten. Diese Angabe dokumentiert die Herkunft des Vertrags. Sie entscheidet nicht über den Prüfalgorithmus. Im Test läuft dasselbe Layout mit beiden Metadatenprofilen erfolgreich durch.
Das hält die Tür für spätere Profilgeneratoren offen: Ein Generator könnte aus einem Copybook, einer RPGLE-Definition oder einem DDL-Skript einen Entwurf erzeugen. Die Freigabe dieses Entwurfs bleibt aber eine fachliche und technische Entscheidung. Automatische Ableitung ist nicht dasselbe wie automatisch erkannte Wahrheit.
Findings und Exit-Codes lesen
Ein Fixed-Width-Typfehler sieht im JSON-Bericht genauso aus wie ein CSV-Typfehler, nur der Datenpfad benennt records statt rows:
{
  "status" : "INVALID",
  "valid" : false,
  "findings" : [ {
    "instancePath" : "/records/0/quantity",
    "schemaPath" : "/columns/quantity/type",
    "keyword" : "type",
    "message" : "Zeile 1, Spalte quantity: 'three' ist keine ganze Zahl"
  } ]
}
Die Felder status, valid und findings bleiben stabil. Automatisierung sollte auf Status, Pfad und Schlüsselwort reagieren. Der genaue Meldungstext ist für Menschen hilfreich, aber kein langfristiger Maschinenvertrag.
| Fehler | Beispielpfad | Einordnung |
|---|---|---|
| Pflichtwert fehlt | /rows/0/quantity |
Vertragsverletzung, Exit 1 |
| CSV-Kopfzeile passt nicht | /header |
Vertragsverletzung, Exit 1 |
| Fixed-Width-Länge falsch | /records/0 |
Vertragsverletzung, Exit 1 |
| Profil ungültig | kein Ergebnis | Prüfung nicht möglich, Exit 2 |
| Zeichen nicht decodierbar | kein Ergebnis | Prüfung nicht möglich, Exit 2 |
Warum der Kern technologieoffen bleibt
Der gemeinsame Kern kennt weiterhin nur Ergebnisobjekte und das Validator-Interface. JSON Schema, CSV-Profil und Fixed-Width-Profil leben in getrennten Adaptern. Auch Apache Commons CSV ist nur eine Bibliotheksentscheidung innerhalb des CSV-Adapters.
| Baustein | Verantwortung | Bewusst nicht |
|---|---|---|
core |
Finding, Status, Ergebnis und Port | CSV-, Fixed-Width- oder Validatorbibliothek kennen |
adapter.csv |
Quoting, Trennzeichen, Header und CSV-Spaltenregeln | FTP/SFTP-Verbindung oder JSON-Schema-Universalmodell |
adapter.fixedwidth |
Datensatzlänge, Positionen und Legacy-Layoutregeln | COBOL-/RPG-Parser oder automatische Quelltextinterpretation |
cli |
Formatwahl, Report und Exit-Code | Fachliche Mehrdatei-Orchestrierung |
Spring Boot bleibt dadurch eine mögliche spätere Auslieferungsschicht, aber keine Voraussetzung des Kerns. Ein HTTP-Dienst, ein Batch-Worker oder eine lokale CLI könnte dieselben Validatoren verwenden. Die Entscheidung für einen neuen Betriebsweg folgt erst, wenn ein konkreter Anwendungsfall ihn rechtfertigt.
Der automatisierte Nachweis
Die Iteration gilt nicht deshalb als abgeschlossen, weil zwei Happy-Path-Dateien existieren. Die Tests decken gültige Dateien, Typfehler, fehlende Pflichtwerte, falsche CSV-Kopfzeilen, falsche Spaltenanzahl, kaputte CSV-Quoting-Syntax, Fixed-Width-Längenfehler und ungültige Profile ab.
🟢 Reproduzierbarer Ablauf
Im Repository stehen die Profile und Fixtures neben dem Java-Code. mvn test führt 64 Tests aus; unter Windows werden zwei Tests für symbolische Links übersprungen, wenn die lokale Berechtigung dafür fehlt. Der Package-Build startet anschließend das JAR mit gültigen und ungültigen CSV- sowie Fixed-Width-Fixtures. Die absichtlich ungültigen Fälle müssen Exit-Code 1 liefern; zusätzliche CLI-Tests sichern die AUTO-Erkennung ab.
Der Nachweis bleibt lokal. Er belegt noch nicht, dass eine Datei per SFTP sicher abgeholt, ein Lieferfenster überwacht oder ein Gegenstück fachlich korrekt betrieben wird. Er belegt aber, dass die erste Schicht nach dem Eintreffen der Datei reproduzierbar prüfen kann, was geliefert wurde.
Was noch bewusst nicht enthalten ist
- kein FTP- oder SFTP-Adapter und keine Authentifizierung;
- keine Prüfung von Dateinamen, Lieferfenstern, Hashes oder Quarantäne;
- keine fachlichen Regeln über mehrere Datensätze oder Dateien;
- keine automatische Ableitung aus DDL, COBOL-Copybooks, DDS oder RPGLE;
- keine bytegenaue Fixed-Width-Semantik oder spezielle EBCDIC-Profilierung;
- keine Größenlimits, Streamingstrategie oder öffentlich erreichbare Service-Sandbox.
Diese Grenzen sind kein Mangel im Vertrag, sondern schützen den vertikalen Durchstich. Die nächste Erweiterung kann gezielt einen Transport- oder Profilgenerator untersuchen, ohne die bisherigen Aussagen nachträglich zu verwischen.
Fazit: Profile machen Dateiverträge sichtbar
Die Antwort auf „Wie kann man Schnittstellen automatisch testen?“ wird mit jeder konkreten Schnittstelle besser: CSV-Dateien brauchen Regeln für Lesen und Spalten; Fixed-Width-Dateien brauchen Positionen und Längen; Legacy-Herkunft kann dokumentiert werden, ohne den Prüfer an COBOL oder RPG zu binden.
Der gemeinsame Kern ist das Ergebnis: Gültige Daten, Vertragsverletzungen und technische Fehler werden in beiden Dateiadaptern gleich unterschieden. So wächst das Werkzeug schrittweise, ohne ein künstliches Universal-Schema zu behaupten.
Die Project-Page „Schnittstellen automatisch testen“ ordnet diese Iteration in die Gesamtidee ein. Die erste JSON-Stufe erklärt der Subartikel zu Iteration 1.
Code und Quellen
Technischer und redaktioneller Stand: 17. September 2026. Der Artikel beschreibt den auf main synchronisierten Stand von Iteration 2.


 tiny-tool.de