Von der allgemeinen Frage zum prüfbaren Qualitätsprozess
Schnittstellen automatisch testen: APIs, Dateien und Legacy-Daten sicher validieren
„Wie kann man Schnittstellen automatisch testen?“ Die Frage klingt nach einer einzelnen Methode. In der Praxis ist sie zunächst zu allgemein. Eine Web-API, eine JSON-Datei aus einem SFTP-Postfach und ein nächtlicher Export aus einem Legacy-System übertragen zwar alle Daten – geprüft werden müssen sie aber auf unterschiedliche Weise.
Meine Antwort im Workshop war deshalb: Durch Schema-Validierung – aber es kommt auf die Schnittstelle an. Daraus entsteht hier ZEUS Interface Quality: ein kleines, erweiterbares Werkzeug für automatische Qualitätssicherung. Nach der JSON-Prüfung, den lokalen Datei-Profilen und dem HTTP-Vertrag kann der aktuelle Stand nun auch SFTP-Lieferungen über Verzeichnisauswahl, Liefer-ID, Claim, stabile Snapshots, SHA-256, Quarantäne und Erfolgsarchiv prüfen. Diese Project-Page erklärt die Idee und den aktuellen Stand; die Praxisartikel zu Iteration 1, Iteration 2, Iteration 3, Iteration 4 und Iteration 6 zeigen den Weg vom Beispiel bis zum automatisierten Test.
Aktueller Stand
Diese Box fasst den aktuellen Stand für alle zusammen, die später wiederkommen. Die Abschnitte darunter erklären die geltende Idee; im Logbuch halten wir die Entwicklung fest.
- Phase: Iteration 6 abgeschlossen – lokale JSON-, CSV-, Fixed-Width-, HTTP- und SFTP-Vertragsprüfung mit korrelierter Lieferungsverwaltung
- Umgesetzt: Java-21-CLI mit JSON Schema, Datei-Profilen, JDK-HttpClient und key-basierter SFTP-Prüfung mit Host-Key, Stabilitätscheck, SHA-256, Liefer-ID, Claim, Archiv und optionaler Quarantäne
- Ergebnis: Text oder JSON; Exit-Code
0für gültige Daten,1für Vertragsverletzungen und2, wenn die Prüfung nicht ordnungsgemäß durchgeführt werden kann - Nachweis: öffentliches Repository, 86 automatisierte Tests, JAR-Rauchtests, lokale HTTP-Loopback-Tests und Embedded-SFTP-Integrationstests
- Zum Nachmachen: JSON-Dateien automatisch validieren: von JSON Schema zum CI-Test, CSV und Legacy-Dateien, HTTP, Status, Header und JSON-Verträge, SFTP-Dateien sicher validieren und SFTP-Lieferungen korrelieren und archivieren
- Noch nicht umgesetzt: OpenAPI-Ableitung, OAuth/API-Key/mTLS-Secret-Verwaltung, XML, YAML, gemischte Mehrdatei-Formate, fachliche Cross-File-Regeln und automatische Profilableitung aus DDL, COBOL oder RPG.
Die Kurzantwort
Schnittstellen testet man automatisch mit mehreren Prüfschichten: Verbindung und Authentifizierung, Parsing, Schema oder Vertrag, fachliche Regeln und – falls nötig – ein Abgleich mit Erwartungs- oder Referenzdaten.
- Den Typ der Schnittstelle und ihren Transportweg bestimmen.
- Ein versioniertes Schema oder einen formalen Schnittstellenvertrag festlegen.
- Einen Adapter für HTTP, Dateiübertragung oder das Legacy-Format verwenden.
- Die eingehenden Daten parsen und gegen das Schema prüfen.
- Zusätzlich fachliche Regeln, Mengen, Querverweise und Dubletten prüfen.
- Ein maschinenlesbares Ergebnis mit Fehlerpfad, Datei, Request-ID oder Datensatznummer erzeugen.
Merksatz: Ein Schema beantwortet „Ist die Nachricht strukturell erlaubt?“. Ein vollständiger Schnittstellentest beantwortet zusätzlich „Konnte ich sie sicher abholen?“ und „Ist sie fachlich plausibel?“
Das ist der übergreifende Testansatz. Unser Werkzeug deckt davon bisher das lokale Einlesen, die Schema-Prüfung und den Bericht ab.
🔴 Ein verbreiteter Irrtum
„Wenn die Datei dem Schema entspricht, funktioniert die Schnittstelle.“
Das stimmt nur für einen Teil der Strecke. Eine Datei kann strukturell gültig und trotzdem unbrauchbar sein – etwa weil sie im falschen Ordner liegt, doppelt geliefert oder falsch codiert wurde. Eine API kann gültiges JSON liefern und trotzdem den falschen HTTP-Status, eine unerwartete Version oder eine inkonsistente Seitenzählung zurückgeben.
Schema-Validierung ist deshalb der zentrale Baustein, aber nicht der komplette Testplan.
Warum die Frage zu allgemein ist
Der Begriff Schnittstelle beschreibt zunächst nur eine Grenze zwischen zwei Systemen. Über diese Grenze können HTTP-Requests und -Responses fließen. Es können aber auch Dateien in einem FTP- oder SFTP-Postfach liegen, Nachrichten in einer Queue warten oder Datensätze aus einem alten Host-Export kommen. Jede Variante bringt eigene Fehlerbilder mit.
| Schnittstellentyp | Typische Fehler | Geeigneter Startpunkt |
|---|---|---|
| Web-API | Falscher Statuscode, Authentifizierung, kaputte Response-Struktur, Versionsbruch, Rate Limit | OpenAPI-Vertrag, JSON Schema, HTTP- und Contract-Tests |
| Datei per FTP/SFTP | Datei fehlt, falscher Name, Encoding, Trennzeichen, Spaltenreihenfolge, unvollständige Übertragung | Transport- und Dateiadapter plus Format-Schema |
| Legacy-Export | Fixed-Width-Verschiebung, implizite Codes, alte Datumsformate, DDL ohne Fachregeln, Mischversionen | Parser-Profil, aus Beispielen/DDL abgeleitetes Schema und fachliche Zusatzregeln |
| Message Queue | Falsches Topic, fehlende Message-Properties, Reihenfolge, Wiederholung, Dead Letter | Nachrichtenvertrag, Consumer-Test und Idempotenzprüfung |
Die erste Designentscheidung lautet daher nicht „Welches Test-Framework verwenden wir?“, sondern: Welche Eigenschaften einer Übergabe sollen als Vertrag gelten? Erst danach wählen wir Validator, Client und Test-Framework aus. Für CSV und Fixed-Width haben wir diese Frage mit kleinen, formatbezogenen Profilen beantwortet.
Was soll eigentlich getestet werden?
Ein guter automatischer Test lässt sich in Ebenen zerlegen. Das verhindert, dass ein einziger grüner Testlauf zu viel verspricht.
| Ebene | Frage | Beispiel |
|---|---|---|
| Transport | Ist der Kommunikationsweg erreichbar? | HTTP-Endpunkt, SFTP-Verzeichnis, Port, Timeout, TLS- beziehungsweise Host-Key-Prüfung |
| Authentifizierung | Darf der Test-Client zugreifen? | API-Key, OAuth 2.0 Client Credentials, mTLS, Basic Auth im Ausnahmefall, SSH-Key |
| Parsing | Kann die Antwort als Daten gelesen werden? | JSON, XML, CSV, UTF-8, EBCDIC-Konvertierung, Fixed-Width, ZIP |
| Struktur | Entspricht die Nachricht dem vereinbarten Vertrag? | Pflichtfelder, Datentypen, Wertebereiche, Reihenfolge, zusätzliche Felder |
| Fachlichkeit | Ist die Nachricht inhaltlich plausibel? | Von-Datum liegt vor Bis-Datum, Summe stimmt, Statusübergang ist erlaubt |
| Vollständigkeit | Fehlt eine Lieferung oder ein Datensatz? | Datei wird erwartet, Datensatzanzahl stimmt, laufende Nummer ohne Lücke |
| Wiederholbarkeit | Was passiert bei Retry oder doppelter Lieferung? | Idempotenzschlüssel, Dublettenprüfung, sichere Wiederanlaufstrategie |
Die ersten beiden Iterationen konzentrieren sich auf Parsing und Struktur. Die übrigen Ebenen bleiben eigenständige Aufgaben für spätere Adapter. Nicht jede Legacy-Datei braucht OAuth, und nicht jede API braucht eine Prüfung des Dateinamens. Eine gemeinsame Ergebnisstruktur soll die Berichte trotzdem vergleichbar halten.
Schnittstellentypen und Startpunkte
Web-APIs, Dateien und Legacy-Exporte sind die drei Anwendungsfelder der Projektidee. Praktisch begonnen haben wir mit einer lokalen JSON-Datei, haben CSV- sowie Fixed-Width-Dateien ergänzt, in Iteration 3 einen begrenzten HTTP-Adapter und in Iteration 4 einen begrenzten SFTP-Adapter umgesetzt. Die folgenden Abschnitte beschreiben, was ein vollständiger Betriebs- und API-Vertrag zusätzlich braucht; Directory-Polling, Mehrdatei-Korrelation und Message-Queue-Adapter bleiben spätere Themen.
1. Web-APIs: Vertrag plus Verhalten
Bei einer HTTP-API ist die Response mehr als ein Datenobjekt. Auch Methode, URL, Header, Statuscode, Laufzeit, Authentifizierung und Fehlerformat gehören zum Vertrag. Ein Schema kann prüfen, ob customerId eine Zeichenkette ist und items ein Array enthält. Es entscheidet aber nicht allein, ob GET /orders/123 bei fehlender Berechtigung mit 403 oder 404 antworten soll.
Für APIs ist deshalb OpenAPI als äußerer HTTP-Vertrag sinnvoll. Die Datenmodelle können darin mit JSON-Schema-kompatiblen Regeln beschrieben werden. Darauf bauen Tests für Statuscodes, Header, Requests und Responses auf. Der Validator ist ein Teil des Contract-Tests – nicht sein Ersatz.
2. Dateien: erst lesen, dann validieren
Eine per FTP oder SFTP bereitgestellte Datei hat Eigenschaften außerhalb ihres Inhalts: Namenskonvention, Ablageort, Lieferfenster, Kompression, Encoding, Prüfsumme und eine Regel für „fertig geschrieben“. Eine valide CSV-Datei kann trotzdem abgeschnitten sein, wenn der Sender sie noch hochlädt und der Empfänger sie zu früh abholt.
Dafür braucht der Datei-Adapter einen klaren Ablauf: Datei finden, Stabilität oder Marker prüfen, sicher übertragen, Hash und Größe dokumentieren, parsen, validieren, in Quarantäne oder Verarbeitung verschieben und das Ergebnis protokollieren.
3. Legacy-Schnittstellen: Vertrag aus Realität und Regeln
Bei alten Schnittstellen existiert das Schema häufig nicht als gepflegte Datei. Dann sind Beispieldaten, DDL-Scripte, Feldbeschreibungen, COBOL-Copybooks, RPG-Quellcode (beispielsweise RPGLE) oder ein bestehender Importer wertvolle Hinweise. Sie liefern aber nicht automatisch die fachliche Wahrheit. Ein Feld kann laut DDL VARCHAR(10) sein und trotzdem nur einen festen Statuscode erlauben.
Die sinnvolle Reihenfolge lautet: einen Schema-Entwurf ableiten, ihn mit der Fachlichkeit abgleichen, bewusst freigeben und als versionierten Vertrag speichern. Die automatische Ableitung spart Arbeit. Sie ersetzt aber nicht die Entscheidung, welche Abweichung ein Fehler und welche eine erlaubte Ausnahme ist.
Welches Schema-Format passt?
Die naheliegenden Formate haben unterschiedliche Rollen. Deshalb sollten sie nicht gegeneinander ausgespielt werden.
| Format | Stärke | Rolle im Projekt |
|---|---|---|
| JSON Schema | Strukturelle Regeln, Wertebereiche und Formate für JSON-Daten | Umgesetzt für Datei- und HTTP-Request-/Response-Daten; normalisierte Mehrfachabläufe sind später |
| OpenAPI | HTTP-Routen, Methoden, Parameter, Statuscodes, Security und Datenmodelle in einem API-Vertrag | API-Adapter und Contract-Tests; nicht als universelles Dateiformat |
| XML Schema / XSD | Etablierte Validierung von XML-Struktur, Typen, Namespaces und Kardinalitäten | XML-Adapter; vorhandene XSDs direkt nutzen |
| YAML Schema | Möglicher Ansatz für YAML-spezifische Verträge | Offene Evaluierung; auch das Parsen in ein JSON-kompatibles Datenmodell wäre erst eine spätere Erweiterung |
| Adapter-Profil | Beschreibt CSV, Fixed-Width oder proprietäre Formate, die kein passendes Standard-Schema haben | Für CSV und Fixed-Width umgesetzt; Ergebnis wird in ein gemeinsames Prüfmodell übersetzt |
🟢 Unsere erste umgesetzte Entscheidung
JSON Schema Draft 2020-12 ist der Datenvertrag; CSV, Fixed-Width und HTTP nutzen jeweils passende Adapterprofile. OpenAPI bleibt der mögliche äußere Vertrag für einen späteren vollständigen API-Adapter. Technologieoffen bedeutet hier: Wir wählen für konkrete Anwendungsfälle passende Werkzeuge, halten ihre Abhängigkeiten aber aus dem Kern heraus. Ein späterer XML-Adapter muss seine Daten nicht künstlich in JSON umschreiben.
Warum JSON Schema unser Startpunkt ist
JSON Schema ist für den Einstieg praktisch, weil Schema und Testdaten beide JSON sein können. Es beschreibt Typen, Pflichtfelder, Arrays, Wertebereiche, Muster und Zusammensetzungen. Das Schema lässt sich versionieren, überprüfen und in vielen Programmiersprachen validieren.
Unser erstes ausführbares Beispiel beschreibt eine Liefermeldung mit Kennung, Menge, E-Mail-Adresse und Lieferadresse. Das Schema gehört zusammen mit seinen Testdaten ins Repository:
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "delivery.schema.json",
  "title": "Delivery",
  "type": "object",
  "additionalProperties": false,
  "required": ["deliveryId", "quantity", "email", "address"],
  "properties": {
    "deliveryId": { "type": "string", "minLength": 1 },
    "quantity": { "type": "integer", "minimum": 1 },
    "email": { "type": "string", "format": "email" },
    "address": { "$ref": "refs/address.schema.json" }
  }
}
Die Adresse liegt in einer zweiten Schema-Datei unter refs/address.schema.json. Das vollständige Beispielverzeichnis enthält beide Schemas sowie gültige und fehlerhafte Lieferungen. Die lokale Datei mit quantity: 3 besteht die Prüfung; die Zeichenkette "three" verletzt den vereinbarten Typ.
Ein wichtiges Detail: format ist in Draft 2020-12 nicht automatisch eine verbindliche Prüfung. Wir aktivieren die Format-Assertions ausdrücklich, damit eine offensichtlich fehlerhafte E-Mail-Adresse als Vertragsverletzung gemeldet wird. Eine Erreichbarkeitsprüfung des Postfachs ist das nicht. Hintergrund: Format-Annotation und Format-Assertion.
Entscheidend ist, dass der Vertrag verständlich bleibt: Welche Felder sind Pflicht? Welche zusätzlichen Felder sind erlaubt? Wie streng ist ein Format? Und welche Aussagen gehören gar nicht in das Schema, sondern in eine fachliche Regel? Die Regel „Die Summe aller Positionen muss dem Gesamtbetrag entsprechen“ ist häufig in einer eigenen, gut lesbaren Prüflogik besser aufgehoben.
🧭 Schema-Versionen gehören zum Test
Für Iteration 1 werden Schema, Testdaten und Code gemeinsam in Git versioniert. Der Praxisartikel verweist auf einen festen Commit, damit sein Ergebnis später reproduzierbar bleibt. Der aktuelle JSON-Bericht enthält noch keine Schema-ID oder Versionsangabe; diesen Kontext hält vorerst der Aufruf beziehungsweise der CI-Lauf fest.
Architektur: kleiner Kern, offene Anschlüsse
Der aktuelle Stand besteht aus einem Maven-Modul auf Java 21. Der Kern definiert eigene Ergebnisobjekte und eine Validator-Schnittstelle. JSON-, CSV-, Fixed-Width- und HTTP-Adapter kapseln ihre jeweiligen Parser und Profilregeln; die CLI nutzt Picocli. Separate Ausgabe-Bausteine schreiben Text oder JSON. Spring Boot ist dafür derzeit nicht nötig.
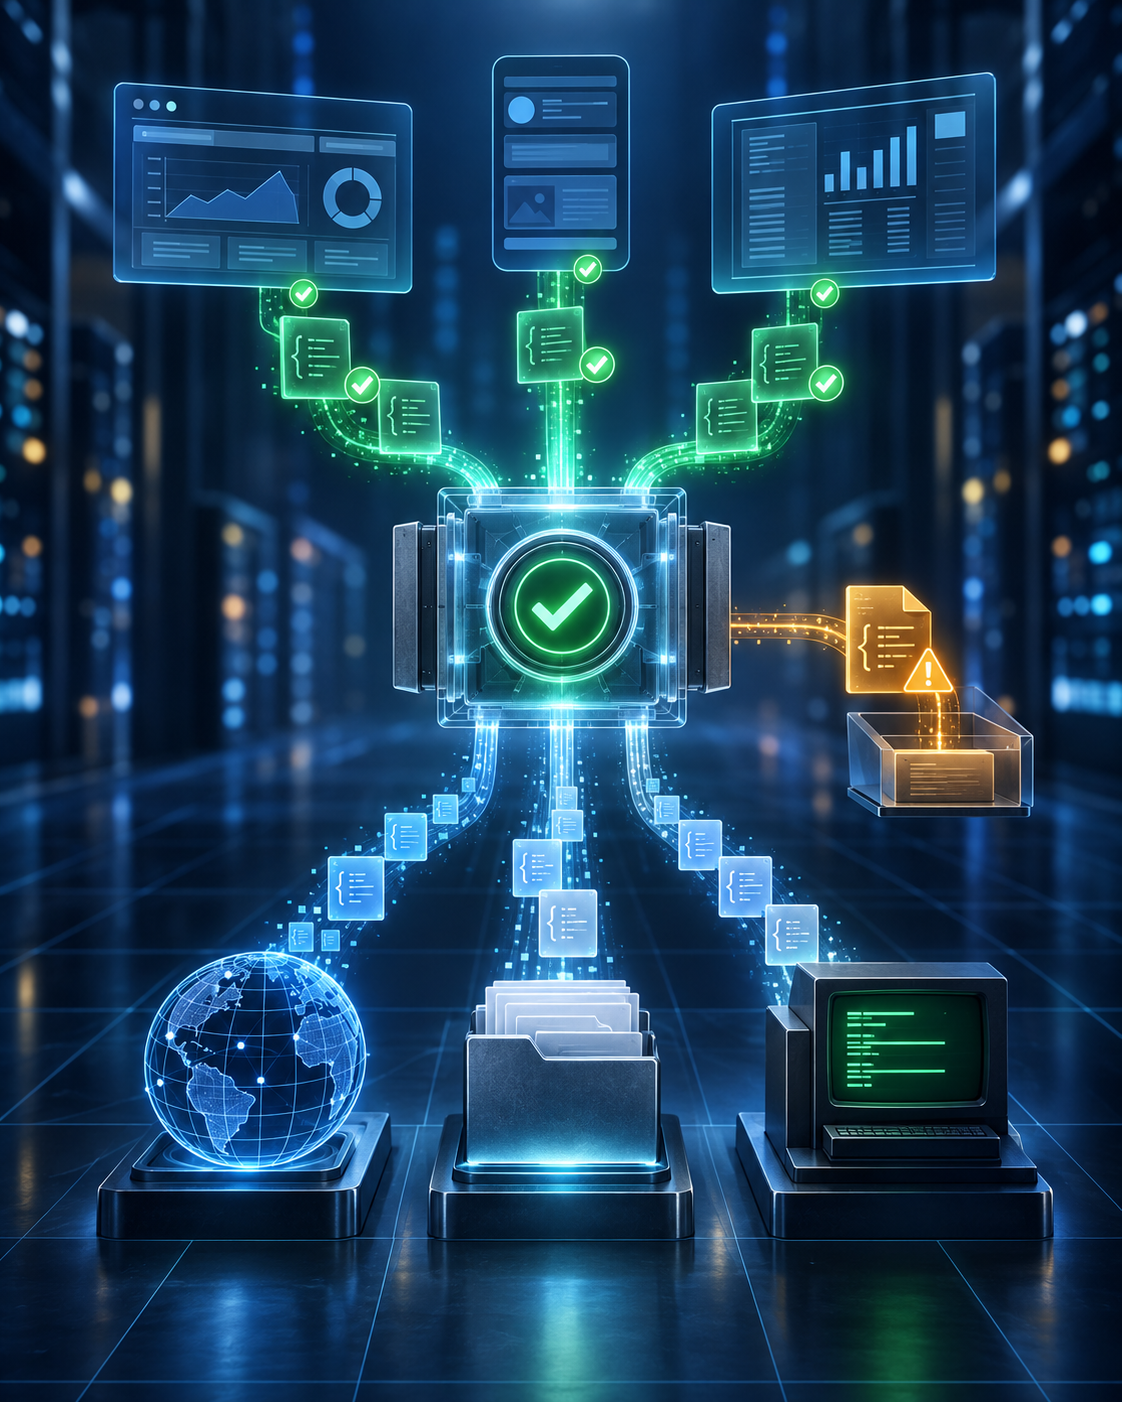
Das hält die Bibliotheken austauschbar, macht den Java-Code aber nicht sprachunabhängig. Ein späterer Spring-Boot-Server könnte den Kern einbinden, wenn ein konkreter Anwendungsfall dafür spricht. Die folgende Strecke zeigt, wie vorhandene Dateiadapter und spätere Transportadapter in dieselbe Ergebnisstruktur münden:
Bei einer späteren Erweiterung müssen wir diese Aufgaben sauber zuordnen:
- Quelle: Woher kommen Daten und Metadaten?
- Authentifizierung: Wie wird sie konfiguriert, ohne Geheimnisse in Schema oder Repository zu speichern?
- Lesen: Wie wird eine Antwort oder Datei zuverlässig abgeholt?
- Normalisieren: Wie werden Inhalt, Transportdetails und technische Metadaten zusammengeführt?
- Prüfen: Welcher Strukturvertrag und welche fachlichen Regeln gelten?
- Ergebnis: Wie sieht ein einheitlicher Fehler aus, den Menschen und automatisierte Abläufe gleichermaßen verstehen?
Der aktuelle Ergebnisvertrag bleibt bewusst klein: status, valid und eine sortierte Liste findings. Quelle, Zeitpunkt, Schema-ID, Hash oder HTTP-Metadaten sind mögliche spätere Ergänzungen, keine bereits verfügbaren Felder. Secrets, Tokens und vollständige personenbezogene Nutzdaten gehören grundsätzlich nicht ungefiltert in einen Report.
Dateien automatisch prüfen
Die erste praktische Iteration prüfte eine bereits lokal vorhandene JSON-Datei. Iteration 2 ergänzt lokale CSV- und Fixed-Width-Dateien; Iteration 3 führt einen lokalen HTTP-Aufruf gegen ein Profil aus; Iteration 4 holt genau eine stabile SFTP-Datei ab und validiert sie; Iteration 5 wählt genau eine passende Datei aus einem SFTP-Verzeichnis. Mehrdatei-Lebenszyklen, Claim-/Lock-Protokolle und Betriebsorchestrierung bleiben getrennte Aufgaben.
Zielbild für einen vollständigen Datei-Ablauf
- Den erwarteten Eingang prüfen: Pfad, Dateiname, Lieferfenster und erlaubte Erweiterung.
- Erkennen, ob die Datei vollständig geschrieben wurde – etwa über eine temporäre Endung, eine Done-Datei, eine stabile Größe oder eine Prüfsumme.
- Datei sicher abholen und technische Metadaten erfassen.
- Encoding und Dateiformat prüfen, bevor die erste Fachregel läuft.
- Datensätze parsen und gegen das Format-Schema validieren.
- Fachliche Regeln, Mengen und Dubletten prüfen.
- Bei Fehlern die Datei unverändert in Quarantäne ablegen und einen nachvollziehbaren Bericht erzeugen.
Für JSON ist genau ein Dokument pro Datei erlaubt; JSONL benötigt weiterhin einen eigenen Ablauf pro Datensatz. CSV und Fixed-Width besitzen inzwischen eigene Version-1-Profile. Die CLI kann das Format ausdrücklich erhalten oder es mit --input-format AUTO aus dem Profilfeld format ableiten. Transport, Dateilebenszyklus und fachliche Mehrdatei-Regeln bleiben davon getrennte Aufgaben.
{
  "format": "csv",
  "version": 1,
  "encoding": "UTF-8",
  "delimiter": ";",
  "header": ["id", "amount", "currency"],
  "columns": [
    { "name": "id", "type": "string", "required": true },
    { "name": "amount", "type": "decimal", "minimum": 0, "maximum": 100000, "required": true },
    { "name": "currency", "type": "string", "minLength": 3, "maxLength": 3, "pattern": "^[A-Z]{3}$", "required": true }
  ]
}
Dieses Profil entspricht dem aktuell unterstützten CSV-Vertrag. Ein separates Fixed-Width-Profil beschreibt stattdessen Positionen, Längen und Padding. Die ausführbaren Beispiele, die gemeinsame Validierung und die unterschiedlichen Fehlerfälle zeigt der Subartikel zu Iteration 2.
⚠️ Dateien nicht zu früh als „fertig“ behandeln
Ein leicht übersehener Fehler ist der Zugriff auf eine Datei, die noch übertragen wird. Eine stabile Dateigröße oder eine Done-Datei kann helfen, ist aber kein universelles Rezept. Je nach Gegenstelle sind atomisches Umbenennen, Prüfsummen oder ein abgestimmtes Lieferprotokoll besser. Dieser Transporttest gehört vor die Schema-Validierung und ist noch nicht Teil unseres Werkzeugs.
Web-APIs mit Vertrag und Authentifizierung testen
Der aktuelle API-Adapter konzentriert sich zunächst auf einen bekannten Endpunkt und prüft dabei mehrere Eigenschaften:
- Erreichbarkeit, TLS und Timeout-Verhalten
- korrekte HTTP-Methode, URL, Header und Content-Type
- Authentifizierung und Berechtigungen
- erwartete Statuscodes für Erfolg und definierte Fehlerfälle
- Request- und Response-Schema
- Pagination, Rate Limits, Correlation-ID und Wiederholbarkeit
Bei der Authentifizierung sollte der Test nur ein Profil referenzieren, zum Beispiel oauth2-client-credentials, api-key, mtls oder basic. Die konkreten Werte kommen aus Umgebungsvariablen, einem Secret Store oder einer CI-Konfiguration. Weder der Schema-Entwurf noch ein Test-Report sollte echte Tokens, private Zertifikate oder Passwörter enthalten.
| Option | Typischer Einsatz | Worauf der Test achten sollte |
|---|---|---|
| API-Key | Einfache interne oder externe APIs | Headername, fehlender Key, falscher Key und versehentliche Ausgabe im Log |
| OAuth 2.0 Client Credentials | Service-zu-Service-Kommunikation | Token-Abruf, Scope, Ablauf, erneuter Abruf und sichere Maskierung |
| mTLS | Stärker abgesicherte B2B-APIs | Zertifikatskette, Ablauf, Client-Zertifikat und getrennte Testumgebung |
| SSH-Key | SFTP und bestimmte Legacy-Übertragungen | Host-Key-Prüfung, Berechtigungen, Schlüsselpfad und kein privater Key im Report |
| Basic Auth | Nur wenn der Bestand es verlangt | TLS, Secret-Handling, Rotation und möglichst enger Testzugang |
Iteration 3 deckt bereits einen gültigen Request, einen fehlenden oder falschen Request-Wert, einen nicht passenden Status, einen fehlenden Pflicht-Header, einen falschen Response-Typ, kaputtes JSON und einen Transportfehler ab. Berechtigungsprofile, Rate Limits und fachliche Mehrschritt-Szenarien gehören in spätere Iterationen.
Legacy-Schnittstellen nachträglich beschreiben
Ein nachträglich erstelltes Schema ist kein minderwertiger Ersatz für eine offizielle Spezifikation. Es ist häufig der realistischste Weg, um aus implizitem Wissen einen überprüfbaren Vertrag zu machen.
Beispieldaten als Ausgangspunkt
Aus mehreren historischen Dateien lässt sich ein erster Schema-Entwurf ableiten: Welche Spalten kommen immer vor? Welche Werte haben denselben Datentyp? Welche Felder sind gelegentlich leer? Bei nur einem Beispiel wäre die Gefahr groß, Zufälligkeiten als Regeln festzuschreiben. Deshalb sollten Beispiele aus verschiedenen Tagen, Grenzfällen und Fehlerfällen betrachtet werden.
DDL als technischer Hinweis
DDL-Scripte liefern Spaltennamen, Längen, Datentypen, Nullbarkeit und manchmal Schlüssel. Das ist eine gute strukturelle Basis. Sie beantworten aber selten Fragen wie „Darf ein Auftrag den Status X haben?“ oder „Muss die Summe exakt aufgehen?“. Diese Regeln gehören in ein ergänzendes Profil oder in fachliche Tests.
Der Review-Schritt ist Teil der Automatisierung
- Beispiele und DDL importieren.
- Den Schema-Entwurf erstellen und unsichere Regeln markieren.
- Fachliche Eigentümer nach Pflichtfeldern, Codes und Grenzwerten fragen.
- Gültige und ungültige Fixtures festlegen.
- Schema als Version 1 freigeben und in die Testläufe aufnehmen.
- Neue Abweichungen als bewusste Schemaänderung behandeln – nicht als stilles „Anpassen, bis es grün ist“.
🟢 Gute Legacy-Regel
Aus Beispieldaten darf man Vorschläge ableiten, aber keine Geschäftsregeln erfinden. Ein automatisch generiertes Schema sollte als Entwurf erkennbar sein. Erst die fachliche Freigabe macht daraus einen belastbaren Schnittstellenvertrag.
Aus Validierung wird Qualitätssicherung
Ein auswertbares Ergebnis muss unterscheiden: Verletzen die Daten den Vertrag, oder konnte die Prüfung gar nicht ordnungsgemäß stattfinden? In Iteration 1 bildet die CLI genau diese Grenze ab.
| Exit-Code | Ergebnis | Bedeutung |
|---|---|---|
| 0 | VALID, valid: true |
Die Eingabe erfüllt das ausgewählte JSON Schema oder formatbezogene Profil. |
| 1 | INVALID, valid: false |
Lesbare JSON-, CSV- oder Fixed-Width-Daten verletzen Regeln; die Findings erklären die Abweichungen. |
| 2 | Fehlermeldung auf dem Fehlerausgabekanal, kein JSON-Ergebnis | Zum Beispiel ungültige Syntax, fehlende Datei, fehlerhaftes Profil oder nicht erlaubter Schema-Verweis. |
Die Findings nennen Datenpfad, Schema-Auswertungspfad, Schlüsselwort und Meldung. Ihre Reihenfolge ist fest definiert. Automatisierte Tests können deshalb nicht nur „rot oder grün“, sondern auch den tatsächlichen Bericht mit einem erwarteten Beispiel vergleichen.
Für einen späteren Betrieb kommen weitere Fragen hinzu: Welche Lieferung wurde erwartet? Welche Vertragsversion galt? Ist eine Wiederholung sinnvoll? Der aktuelle Bericht beantwortet diese Fragen noch nicht. Auch fachliche Fehler, etwa eine falsche Positionssumme, sind noch keine eigene Prüfschicht.
Die Idee als fortlaufende Project-Page
Der Artikel darf mit dem Projekt wachsen. So bleiben Entscheidungen nachvollziehbar, und auch lehrreiche Irrwege können ihren Platz behalten. Spätere Implementierungen müssen dadurch nicht so wirken, als wäre die endgültige Architektur schon am ersten Tag bekannt gewesen.
Wir halten die Entwicklung in drei Schichten fest: Die Project-Page beschreibt den geltenden Stand. Das Logbuch bildet die Chronik und wird nur um neue Einträge ergänzt. Ein Sub-Artikel entsteht erst, wenn eine Iteration eigene Beispiele, Ergebnisse oder Fehlversuche mitbringt – nicht als leere Hülle für jede Roadmap-Zeile.
| Schicht | Aufgabe | Wann sie wächst |
|---|---|---|
| Project-Page | Geltender Stand: Kurzantwort, Architektur, Entscheidungen, Roadmap | Immer, wenn sich die Idee ändert – der Text wird aktualisiert, nicht nur ergänzt |
| Logbuch | Chronik, die um Datum, Entscheidung, Begründung und Auswirkung ergänzt wird | Bei jeder Iteration, auch wenn das Ergebnis „nicht umsetzen“ lautet |
| Sub-Artikel | Tiefe zu einer abgeschlossenen oder reichhaltigen Iteration | Erst wenn Fixtures, Code, Messwerte oder ein belastbarer Fehlversuch vorliegen |
🟢 Iteration 1 zum Nachmachen
Die erste Iteration hat jetzt eigene Beispiele, einen eingefrorenen JSON-Bericht und einen automatisierten Nachweis. Im Praxisartikel zur lokalen JSON-Validierung zeigen wir die Aufrufe, die drei Exit-Codes und die Fehlerfälle, die erst beim Review sichtbar wurden.
📌 Was weiterhin gilt
- Die Ausgangsfrage braucht eine Einordnung nach Schnittstellentyp.
- Schema-Validierung ist der gemeinsame Kern für strukturelle Qualität.
- Transport, Authentifizierung, Parsing und fachliche Regeln bleiben eigene Prüfschichten.
- JSON Schema ist der erste kanonische Datenvertrag.
- OpenAPI, XSD und Adapter-Profile werden nicht künstlich ersetzt.
- Beispieldaten und DDL können Legacy-Verträge vorbereiten, brauchen aber Review.
- Das öffentliche Repository versioniert inzwischen Schema, Fixtures, CLI, Berichtsvertrag und Regressionstests gemeinsam.
Jede größere Änderung macht drei Dinge sichtbar: Entscheidung, Begründung und Auswirkung. Wenn später ein anderer Validator gewählt wird oder YAML eine eigene Rolle bekommt, ist das kein Bruch der Idee, sondern eine dokumentierte Iteration. Veraltete Aussagen im Artikel werden aktualisiert; das Logbuch bewahrt, warum sie einmal galten.
Erste Entwicklungsiterationen
Das GitHub-Repository ZEUS Interface Quality enthält inzwischen sechs abgeschlossene vertikale Durchstiche. Die folgenden Schritte sind Möglichkeiten, keine Zusage für bereits verfügbare Funktionen:
| Iteration | Ergebnis | Warum diese Reihenfolge? |
|---|---|---|
| 0 – Grundlage · abgeschlossen | Projektidee, Abgrenzung, Repository und Werkzeugkette | Eine gemeinsame Ausgangsbasis schaffen |
| 1 – JSON-Datei · abgeschlossen | Java-CLI, lokale Schemas, Text/JSON, Exit-Codes 0/1/2, Fixtures, Regressionstests und CI | Den Ablauf von der Eingabe bis zum Ergebnis reproduzierbar belegen |
| 2 – CSV/Legacy-Datei · abgeschlossen | CSV- und Fixed-Width-Adapter mit Profilen, gemeinsamen Regeln, AUTO-Erkennung, Fixtures und Reports | Formatregeln und Ergebnisvertrag getrennt prüfen |
| 3 – HTTP-Adapter · abgeschlossen | Lokales HTTP-Profil, Request-/Response-Schema, Status-, Header- und Content-Type-Prüfung ohne Redirects | Transport und Datenvertrag in einem reproduzierbaren Durchstich zusammenführen |
| 4 – SFTP-Adapter · abgeschlossen | Host-Key, stabiler Snapshot, SHA-256, Inhaltsdelegation und optionale Quarantäne | Den Datei-Lebenszyklus kontrolliert einbeziehen |
| 5 – SFTP-Verzeichnisauswahl · abgeschlossen | Verzeichnisliste, Basename-Regex, begrenztes Warten und genau ein passender regulärer Treffer | Mehrdeutige Lieferungen sicher zurückweisen |
| 6 – SFTP-Lieferzyklus · abgeschlossen | Liefer-ID, Primär-/Begleitdatei, Claim, Wiederanlauf, Archiv, Quarantäne und Lifecycle-Metadaten | Zusammengehörige Lieferungen sicher übernehmen |
| 7 – Ableitung · offen | Schema-Entwürfe aus Beispielen und DDL mit fachlichem Review | Legacy-Bestand schrittweise beschreiben |
| 8 – Betriebsreife · offen | Weitere Berichte, Betriebsmetadaten und dokumentierte Einsatzgrenzen | Reale Nutzung statt zusätzlicher Formate um ihrer selbst willen |
Repository, CI und der gemeinsame JSON-Bericht bilden weiterhin das Fundament. Iteration 6 bündelt die Verzeichnisauswahl mit Liefer-ID, Claim, Wiederanlauf, Erfolgsarchiv und Quarantäne. Der SFTP-Adapter prüft damit nicht nur den Inhalt, sondern auch den Übergang der Lieferung durch den Prüfprozess. Als Nächstes können OpenAPI-Ableitung, Secret-Verwaltung, gemischte Mehrdatei-Formate oder fachliche Mehrschrittregeln separat bewertet werden.
Logbuch
Neueste Einträge stehen oben. Frühere Einträge bleiben als damaliger Stand erhalten. Der aktuelle Stand steht in der Übersicht am Anfang; ausführliche Beispiele gehören in die verlinkten Praxisartikel.
29. September 2026 · Iteration 5 + 6 · Korrelierter SFTP-Lieferzyklus
Entscheidung: Die bisher geplante Verzeichnisauswahl wird mit Liefer-ID, optionaler Begleitdatei, atomarem Claim, Wiederanlauf, Erfolgsarchiv und Quarantäne zu einem Version-3-Profil zusammengeführt.
Begründung: Eine einzelne passende Datei beweist noch keine vollständige Lieferung. Die Besitzgrenze muss vor dem Download sichtbar sein, und ein Neustart darf nicht still eine andere Lieferung auswählen.
Auswirkung: Der vollständige Build umfasst 86 Tests mit 0 Fehlern und 2 erwarteten Skips. Ein Embedded-SFTP-Server prüft den produktiven JSch-Transport; der operative JSON-Report kann den Lifecycle ausweisen.
Öffentliche Artikel: Die Verzeichnisauswahl wird nicht separat veröffentlicht, sondern im neuen SFTP-Lifecycle-Artikel fachlich eingeordnet.
25. September 2026 · Iteration 4 · Begrenzter SFTP-Adapter
Entscheidung: Der nächste vertikale Schnitt validiert genau eine SFTP-Datei über ein lokales Profil. Host-Key und privater Schlüssel bleiben explizit; ein stabiler Remote-Snapshot, optionaler SHA-256-Abgleich und die Delegation an JSON-, CSV- oder Fixed-Width-Validatoren bilden den Prüfablauf.
Begründung: Ein erfolgreicher Download beweist weder eine vollständige Lieferung noch einen vertrauenswürdigen Host oder einen passenden Inhalt. Die Risiken werden deshalb in Vertrauens-, Stabilitäts-, Integritäts- und Inhaltsbefunde getrennt.
Auswirkung: 76 Tests decken gültige Dateien, instabile Metadaten, Hash-Abweichungen, Inhaltsbefunde, Quarantäne und temporäre Downloads ab. Iteration 4 beschreibt Profil, Aufruf, Grenzen und den reproduzierbaren Nachweis.
Offen geblieben: Directory-Auswahl, Mehrdatei-Korrelation, Passwort- oder Agent-Authentifizierung, Erfolg-Archivierung und produktionsnahe Live-Server-Tests blieben damals eigene Entscheidungen.
21. September 2026 · Iteration 3 · Begrenzter HTTP-Adapter
Entscheidung: Der nächste vertikale Durchstich verbindet einen lokalen JSON-Request mit einem echten HTTP- beziehungsweise HTTPS-Aufruf. Ein Version-1-Profil beschreibt Methode, URL, Header, erwarteten Status, Response-Header, Media-Type, Timeout und lokale Request-/Response-Schemas.
Begründung: Ein API-Vertrag besteht nicht nur aus JSON. Status, Pflicht-Header und der Transport selbst müssen sichtbar werden. Der JDK-HttpClient liefert dafür eine kleine Standardbasis, während lokale Loopback-Tests reproduzierbar bleiben und keine externe Gegenstelle benötigen.
Auswirkung: 70 Tests, Package-Build und JAR-Rauchtests sichern nun vier Eingabewege. Request-Verletzungen werden vor dem Versand erkannt; Response-Verletzungen bleiben INVALID, Transport- und Profilfehler bleiben Exit 2. Der Subartikel 3 zeigt Profil, Aufruf und Findings.
Offen geblieben: OpenAPI-Parsing, OAuth/API-Key/mTLS-Secret-Verwaltung, Redirects, Streaming, Mehrschritt-Abläufe sowie SFTP, fachliche Regeln und Betriebsreife bleiben bewusst getrennte Entscheidungen.
17. September 2026 · Iteration 2 · Gemeinsame Regeln und AUTO-Erkennung
Entscheidung: CSV- und Fixed-Width-Adapter teilen die Prüfung gemeinsamer Skalarregeln. Die CLI verwendet standardmäßig AUTO, erkennt CSV- und Fixed-Width-Profile am Feld format und lässt die ausdrückliche Formatwahl weiterhin zu. --profile bleibt als verständlicher Alias für --schema erhalten.
Begründung: Gleiche Regeln für Pflichtwerte, Typen, Längen und Wertebereiche sollten nicht zweimal auseinanderlaufen. Die automatische Auswahl verkürzt Standardaufrufe, während explizite Formate für Skripte und Fehlersuche verfügbar bleiben.
Auswirkung: 64 Tests, Package-Build, JAR-Rauchtests und CI sichern nun auch die gemeinsamen Regeln und die AUTO-Pfade ab. Der Subartikel 2 beschreibt die fachlichen und technischen Grenzen dieser Ausbaustufe.
Offen geblieben: Transportzugriff per FTP/SFTP, API-Adapter, automatische Ableitung aus DDL, Copybooks, DDS oder RPGLE sowie bytegenaue und fachliche Regeln bleiben getrennte nächste Entscheidungen.
16. September 2026 · Iteration 2 · CSV und Fixed-Width als lokale Dateiadapter
Entscheidung: Der erste Dateistrang wird mit zwei eigenen Profilen umgesetzt: CSV für Trennzeichen, Kopfzeile und Spaltenregeln; Fixed-Width für Datensatzlänge, Positionen und Feldlängen. Beide Adapter liefern den bestehenden Report mit den Exit-Codes 0, 1 und 2.
Begründung: Datei-Schnittstellen brauchen formatbezogene Annahmen. CSV hat Quoting und Header, Legacy-Dateien haben feste Positionen und häufig Padding. Ein gemeinsames Universal-Schema würde diese Unterschiede verdecken. Deshalb bleiben die Profile in den Adaptern und der Kern kennt weiterhin nur Ergebnisobjekte.
Auswirkung: 55 Tests, JAR-Rauchtests und CI-Schritte decken gültige und ungültige CSV- sowie Fixed-Width-Fixtures ab. Subartikel 2 erklärt die Beispiele. COBOL und RPG werden als mögliche Herkunft eines Layoutprofils dokumentiert, ohne den Prüfer an eine Sprache zu koppeln.
Offen geblieben: Transportzugriff per FTP/SFTP, API-Adapter, automatische Ableitung aus DDL, Copybooks, DDS oder RPGLE sowie bytegenaue und fachliche Regeln bleiben getrennte nächste Entscheidungen.
15. September 2026 · Iteration 1 · Lokale JSON-Prüfung abgeschlossen
Entscheidung: Java 21, ein Maven-Modul und eine CLI ohne Spring Boot bilden den ersten ausführbaren Stand. JSON Schema Draft 2020-12, aktive Formatprüfungen, lokale Schema-Verweise und ein kleiner Text-/JSON-Bericht sind umgesetzt.
Begründung: Gültige Daten, Vertragsverletzungen und technische Fehler müssen reproduzierbar auseinandergehalten werden. Das Review ergänzte deshalb striktes Einlesen, eine Prüfung der Schemas selbst, abgesicherte lokale Verweise und einen echten CLI-Vergleich mit dem erwarteten Bericht.
Auswirkung: Exit-Codes 0, 1 und 2 sind nachgewiesen. Der Linux-CI-Lauf zu Commit d794151 besteht alle 36 Tests sowie Paketbau und JAR-Smoke-Tests. Der Praxisartikel zu Iteration 1 erklärt die Beispiele und die Erkenntnisse. Repository und CI sind damit bereits Teil der ersten Iteration.
Offen geblieben am damaligen Stand: der konkrete nächste Adapter, fachliche Regeln, Betriebsgrenzen und die Lizenzentscheidung vor einem ersten Release. Die heute abgeschlossene Iteration 2 war zu diesem Zeitpunkt noch nicht gestartet.
13. September 2026 · Iteration 0 · Initiale Project-Page
Entscheidung: Die Ausgangsfrage wird nach Schnittstellentyp zerlegt. JSON Schema Draft 2020-12 ist der erste kanonische Datenvertrag. OpenAPI, XSD und Adapter-Profile bleiben für HTTP, XML und Legacy-Formate zuständig.
Begründung: Ein einziger „Schnittstellentest“ verspricht zu viel. Schema-Validierung ist der gemeinsame Kern, reicht aber ohne Transport, Authentifizierung, Parsing und Fachlichkeit nicht.
Auswirkung: Diese Seite ist der geltende Stand. Es gibt noch kein Repository, keinen Runner und keinen Sub-Artikel. Nächster Nachweis: JSON-Datei gegen versioniertes Schema, Ergebnis mit Fehlerpfad.
Offen geblieben: Laufzeit der CLI, konkretes Report-Format, Umgang mit YAML als eigenem Vertrag.
Offene Fragen
Diese Liste zeigt, was bewusst noch nicht entschieden ist. Sobald eine Frage beantwortet ist, wandert die Entscheidung ins Logbuch und in den geltenden Stand – die Liste wird dann kürzer.
- Welche konkrete OpenAPI- oder Secret-Management-Erweiterung wäre der nächste klar begrenzte HTTP-Schritt?
- Welche Kontextinformationen braucht der Bericht im Betrieb, ohne den bestehenden Vertrag unnötig zu erweitern?
- Welche Grenzen für Dateigröße, Laufzeit und Ressourcen benötigen wir vor einem produktiven Einsatz?
- Wann bekommt YAML einen eigenen Vertrag – und wann reicht „parsen, dann gegen JSON Schema prüfen“?
- Welches Quarantäne- und Retry-Modell gilt als Mindeststandard für Datei-Adapter?
- Welche Lizenz soll für den ersten öffentlichen Release gelten?
Bereits entschieden sind Java 21 als Basis, Text und JSON als Ausgabeformate, der gemeinsame Ergebnisvertrag, eigene Profile für CSV und Fixed-Width sowie das lokale HTTP-Profil mit Request-/Response-Schemas. Unser Lieferbeispiel verbietet zusätzliche Felder beziehungsweise Spalten ausdrücklich; das ist keine globale Vorgabe für jede Schnittstelle.
Was Schema-Validierung nicht leistet
Ein Schema kennt nur Regeln, die darin beschrieben sind. Es kann keine fehlende Fachlichkeit erraten, keine Gegenstelle zur Lieferung bewegen und keinen falsch konfigurierten Benutzerzugang reparieren. Außerdem gibt es Eigenschaften, die absichtlich außerhalb eines reinen Daten-Schemas liegen:
- Verfügbarkeit: Ist der Endpunkt oder das Postfach im Lieferfenster erreichbar?
- Sicherheit: Ist TLS korrekt, wird der Host-Key geprüft und werden Secrets geschützt?
- Performance: Antwortet die API innerhalb der vereinbarten Zeit und unter Last?
- Kompatibilität: Kann ein alter Consumer eine neue, zusätzliche oder entfernte Eigenschaft verarbeiten?
- Fachlichkeit: Passt die Nachricht zum Bestand, zur Reihenfolge und zur Geschäftsregel?
- Betrieb: Werden Retry, Idempotenz, Duplikate und Quarantäne korrekt behandelt?
Gerade diese Grenzen machen die Methode belastbar. Man kann für jede Eigenschaft den passenden Test ergänzen, statt einen einzelnen „Schema-Test“ mit Erwartungen zu überladen.
Glossar
Die wichtigsten Begriffe für die erste Projektfassung.
- Adapter
- Ein Baustein, der einen konkreten Transport oder ein Dateiformat an den gemeinsamen Prüfablauf anschließt.
- API
- Programmierschnittstelle, hier meist eine über HTTP erreichbare Web-API mit Requests, Responses und definierten Statuscodes.
- Contract Testing
- Prüfung, ob eine Schnittstelle den vereinbarten Vertrag zwischen Consumer und Provider einhält.
- DDL
- Data Definition Language: SQL-Anweisungen, die Tabellen, Spalten, Typen und Constraints beschreiben können.
- Fixture
- Reproduzierbare Testdaten, zum Beispiel eine gültige JSON-Datei oder ein bewusst fehlerhafter CSV-Fall.
- JSON Schema
- Ein JSON-basiertes Schemaformat zur Beschreibung und strukturellen Validierung von JSON-Daten.
- Legacy-Schnittstelle
- Bestehende, oft ältere Integrationsstrecke mit proprietärem Format, fehlender Spezifikation oder historisch gewachsenen Regeln.
- OpenAPI
- Eine Spezifikation, mit der HTTP-APIs inklusive Pfaden, Methoden, Parametern, Responses und Sicherheit beschrieben werden.
- Quarantäne
- Getrennter Ablage- oder Statusbereich für fehlerhafte Nachrichten, damit sie nicht versehentlich weiterverarbeitet werden.
- Schema
- Formale Beschreibung, welche Struktur und welche Werte eine Nachricht oder Datei haben darf.
- XSD
- XML Schema Definition: etabliertes Schemaformat für XML-Strukturen, Datentypen und Kardinalitäten.
Häufige Fragen
Reicht JSON Schema für alle Schnittstellen?
Nein. JSON Schema ist ein guter Startpunkt für JSON-Daten und normalisierte Testobjekte. HTTP-Verträge brauchen zusätzlich OpenAPI-Informationen, XML bleibt mit XSD gut beschrieben und CSV oder Fixed-Width benötigen Parser-Profile. Die gemeinsame Ebene sollte das Ergebnis sein, nicht zwangsläufig das Eingabeformat.
Kann man eine CSV-Datei gegen JSON Schema prüfen?
Grundsätzlich ja: Nach dem Parsen kann man die Daten in ein passendes JSON-Modell überführen. Für den ersten Dateipfad bleiben wir jedoch bei eigenen Profilen: Der CSV-Adapter prüft Encoding, Trennzeichen, Header und Spaltenregeln; der Fixed-Width-Adapter prüft Encoding, Datensatzlänge und Positionen. Beide übersetzen ihre Ergebnisse in denselben Report-Vertrag.
Kann man ein Schema aus Beispieldaten erzeugen?
Ja, als Entwurf. Mehrere Beispiele helfen, Typen, Pflichtfelder und Wertebereiche zu erkennen. Die fachliche Prüfung bleibt aber notwendig, weil ein Beispiel keine zuverlässige Aussage darüber liefert, was künftig erlaubt sein soll.
Was ist bei FTP und SFTP zusätzlich zu testen?
Erreichbarkeit, Authentifizierung, Host- beziehungsweise Zertifikatsprüfung, Pfad, Dateiname, Lieferfenster, vollständige Übertragung, Hash, Dateigröße, Quarantäne und Retry-Verhalten. Erst danach wird der Dateiinhalt strukturell und fachlich validiert.
Welche Authentifizierung sollte ein API-Adapter unterstützen?
Als sinnvolle Profile bieten sich API-Key, OAuth 2.0 Client Credentials und mTLS an. Basic Auth sollte nur aus Kompatibilitätsgründen vorhanden sein und immer über eine geschützte Verbindung laufen. Geheimnisse gehören in eine sichere Laufzeitkonfiguration, nicht in Schema-Dateien oder Logs.
Ist ein grüner Schema-Test ein Integrationstest?
Nicht automatisch. Ein Test mit einer lokalen Fixture prüft den Parser und das Schema. Ein echter Integrationstest bezieht außerdem die reale Gegenstelle oder eine realitätsnahe Testumgebung, Transport, Authentifizierung und oft auch Wiederholungs- und Fehlerfälle ein.
Kann ich die erste Version schon ausprobieren?
Ja. Der Praxisartikel zu Iteration 1 führt durch den lokalen Build und drei Beispieldateien. Benötigt werden Git und ein JDK 21; Maven bringt der Wrapper mit. Es handelt sich um einen Entwicklungsstand, noch nicht um einen als produktionsreif freigegebenen Release.
Warum ist der Artikel als Project-Page gedacht?
Weil die beste Architektur erst durch echte Beispiele entsteht. Die Seite hält den geltenden Stand, das Logbuch die Chronik, und Sub-Artikel erst die Iterationen mit Substanz. Leserinnen und Leser sehen dadurch nicht nur ein fertiges Tool, sondern den Weg dorthin.
Fazit: Schnittstellen automatisch testen heißt Verträge prüfbar machen
Die Ausgangsfrage ist als Kurzfrage zu allgemein – und gerade deshalb ein guter Startpunkt. APIs, Dateien und Legacy-Schnittstellen haben unterschiedliche Transportschichten, Formate und Fehlerbilder.
Schema-Validierung ist der gemeinsame Kern: Sie macht sichtbar, ob eine Nachricht strukturell dem vereinbarten Vertrag entspricht. Für eine belastbare Qualitätssicherung kommen Transport, Authentifizierung, Parsing, fachliche Regeln, Vollständigkeit und Wiederholbarkeit dazu.
Umgesetzt sind die lokale Prüfung mit JSON Schema, eigene Profile für CSV und Fixed-Width, ein begrenzter HTTP-Adapter und ein key-basierter SFTP-Lifecycle mit Stabilitäts-, Hash-, Claim-, Archiv- und Quarantäneprüfung. OpenAPI, Secret-Verwaltung, XSD und weitere Betriebsfunktionen bleiben mögliche Erweiterungen.
Der Nachweis wächst: Eine CLI unterscheidet bei fünf Eingabewegen gültige Daten, Vertragsverletzungen und technische Fehler. Die Beispiele zeigen Iteration 1: von der JSON-Datei zum CI-Test, Iteration 2: CSV und Legacy-Dateien, Iteration 3: HTTP, Status, Header und JSON-Verträge, Iteration 4: SFTP-Dateien sicher validieren und Iteration 6: SFTP-Lieferungen korrelieren und archivieren.
Quellen & weiterführende Informationen
Technischer und redaktioneller Stand: 29. September 2026. Die Project-Page beschreibt den auf main synchronisierten Stand von Iteration 6 und die zusammengefasste Darstellung der Iterationen 5 + 6.
- ZEUS Interface Quality: öffentliches Repository
- Iterationsdokumentation und Abnahmekriterien
- GitHub Actions: Test-, Package- und JAR-Nachweise
- JSON Schema: Specification
- JSON Schema: Draft 2020-12
- JSON Schema: Dialect and vocabulary declaration
- OpenAPI Initiative: OpenAPI Specification
- W3C: XML Schema Definition Language (XSD) 1.1
- YAML Schema


 tiny-tool.de
 tiny-tool.de